برای نوشتن پرامپت ساخت ویدئو با هوش مصنوعی، فهرستکردن صفتهایی مثل «سینمایی»، «واقعگرایانه» یا «زیبا» کافی نیست. مدل باید بداند قاب از کجا شروع میشود، در طول کلیپ چه تغییری رخ میدهد و دوربین این تغییر را چطور میبیند. اگر حرکت و ترتیب اتفاقها مبهم باشد، پرامپت هرقدر هم پرجزئیات باشد، بخش مهمی از تصمیم را به مدل واگذار میکند. این راهنما یک چارچوب عملی میدهد و نشان میدهد چرا نباید دستور یک مدل را بیتغییر به مدل دیگر منتقل کرد. [2][3]
پرامپت ویدئو چه فرقی با پرامپت تصویر دارد؟
در تصویر ثابت، معمولاً با یک قاب سروکار داریم: سوژه کجاست، چه نوری دارد و تصویر چه حالوهوایی دارد. ویدئو علاوه بر اینها، به مسیر نیاز دارد. سوژه از کجا حرکت میکند؟ چه زمانی مکث میکند؟ دوربین ثابت میماند یا همراهش میرود؟ در پایان چه چیزی باید در قاب بماند؟
بهجای انباشتن سبکها و صفتها، صحنه را به چند تغییر قابلمشاهده تقسیم کنید. لازم نیست برای هر ثانیه یک دستور بنویسید؛ نقاط مهم شروع، تغییر و پایان را روشن کنید. نمونههای رسمی Seedance 2.5 حرکت دوربین و کنش را در بازههای زمانی کنار هم میگذارند. راهنمای Gemini هم برای رویدادهای زماندار، زبان طبیعی یا بازههایی مانند ۰ تا ۳ ثانیه را پیشنهاد میکند. [3][2]
پیش از نوشتن، نوع کار را انتخاب کنید
یک پرامپت نباید همزمان نقش تصویر مرجع، دستور ویرایش و دستور ادامهٔ ویدئو را بازی کند. اول روشن کنید از مدل چه میخواهید:
- ساخت از متن: صحنه، سوژه، کنش، دوربین و حالوهوا را خودتان تعریف میکنید.
- حرکتدادن یک تصویر: تصویر، ظاهر و ترکیب قاب را میدهد؛ پرامپت باید بیشتر توضیح دهد بعد از آن چه اتفاقی بیفتد.
- حرکت میان فریم اول و آخر: حالت آغاز و مقصد را روشن کنید و مسیر قابلباور میان آن دو را بنویسید.
- ادامه یا ویرایش ویدئو: بگویید کدام بخش تغییر کند، چه چیزی از مرجع حفظ شود و ادامه از کدام لحظه یا وضعیت شروع شود.
این تفاوت در MiniMax H3 صریح است: راهنمای آن مسیرهای جداگانهای برای متن، تصویر آغازین، فریم آغاز و پایان، و فریم پایانی تعریف میکند. راهنمای Gemini هم ویرایش را با یک تغییر مشخص و حفظ بقیهٔ اجزا توضیح میدهد. [4][2]
یک چارچوب ساده برای نوشتن پرامپت
از این ترتیب بهعنوان چکلیست شروع کنید؛ نه فرمول رسمی است و نه تضمین نتیجه:
- نوع کار و مرجع: تولید از متن است، یا تصویر، ویدئو و فریم مرجع دارید؟ هر مرجع چه نقشی دارد؟
- سوژه و قاب آغازین: چه کسی یا چه چیزی، کجا قرار دارد؟ نمای نزدیک میخواهید یا قاب باز؟
- کنش در زمان: سوژه دقیقاً چه میکند؟ حرکت، مکث و واکنش به چه ترتیبی رخ میدهند؟
- دوربین: ثابت میماند، سوژه را دنبال میکند، عقب میرود یا دور آن میچرخد؟ جهت، سرعت و شدت حرکت را فقط وقتی لازم است اضافه کنید.
- پیوستگی و پایان: برداشت پیوسته میخواهید یا چند نما؟ در آخر چه حالت یا تصویری باید در قاب باشد؟
- صدا: گفتوگو، صدای محیط، افکت و موسیقی را جدا کنید. اگر نمیخواهیدشان، همان را روشن بگویید.
- ثابتها و تغییرها: در ویرایش، دقیقاً چه چیزی عوض شود و چه چیزهایی دستنخورده بمانند؟
حرکت سوژه را از حرکت دوربین جدا بنویسید. «زن از اتاق خارج میشود» کنش را مشخص میکند؛ «دوربین از پشت او آرام دنبالش میرود» مسیر نگاه را. راهنمای H3 حرکت دوربین را با نوع، دامنه و سرعت توضیح میدهد؛ لازم نیست هر سه را همیشه پر کنید، فقط وقتی به تصمیم دقیقتری کمک میکنند. [4]
برای صدا هم «موسیقی احساسی» ممکن است بیش از حد کلی باشد. اگر صدا اهمیت دارد، منبع و زمانش را مشخص کنید: باران پیوسته، ضربهای کوتاه هنگام برخورد، یا گفتوگویی با متن معلوم. در قالب پایهٔ H3، صدای صحنه و محیط از موسیقی پسزمینه جداست. Gemini Omni Flash هم بهطور پیشفرض صدا میسازد؛ راهنمای Google میگوید نوع صدای دلخواه را در پرامپت توضیح دهید. [4][2]
تفاوت سه مدل در شیوهٔ نوشتن
نام نمایشی Google «Gemini Omni Flash» است و شناسهٔ پایدار API آن gemini-omni-1.1-flash. بنابراین «Gemini Omni Flash 1.1» برای اشاره به نسخه قابلفهم است، اما نام نمایشی و شناسهٔ مدل یکی نیستند. [1]
| مدل | چه چیزی را برجسته کنید | نکتهٔ اختصاصی |
|---|---|---|
| Gemini Omni Flash | صحنه و کنش، حرکت دوربین، نور و حالوهوا | برای یک برداشت، «یک نمای پیوسته، بدون برش» را صریح بخواهید. در ویرایش کوتاه بگویید چه چیزی تغییر کند و باقی حفظ شود. زمان را طبیعی یا با بازه بنویسید. [2] |
| Seedance 2.5 | توالی زمانی، حرکت سوژه و دوربین، نماها و نقش مراجع | نمونههای رسمی از بازههایی مانند ۰ تا ۵ ثانیه و شناسههایی مثل @Image و @Video استفاده میکنند. این برچسبها را وقتی به کار ببرید که مرجع متناظر را واقعاً وارد کردهاید. [3] |
| MiniMax H3 | نوع ورودی، مسیر صحنه و تفکیک صدا | راهنمای پایه، توصیف زمانمند تصویر و کنش را از صدای محیط و موسیقی غیرروایی جدا میکند. حالت full-reference بخشها و برچسبهای مخصوص خود را دارد. [4][5] |
Gemini Omni Flash ممکن است بهطور پیشفرض چند نما بسازد. اگر صحنه باید یک برداشت بیوقفه باشد، راهنمای رسمی عبارتهایی مثل «یک نمای پیوسته» و «بدون برش صحنه» را صریحاً پیشنهاد میکند. برای ویرایش هم دستور کوتاه و متمرکز را توصیه میکند؛ مثلاً نور را تغییر بده و بقیهٔ ویدئو را حفظ کن. [2]
در Seedance 2.5، نمونههای رسمی prompt را در خط زمانی پیش میبرند: بازهٔ زمانی، کنش، حرکت دوربین و مرجع در همان بخش کنار هم میآیند. اگر تصویر یا ویدئویی وارد کردهاید، نقش آن را هم بنویسید؛ مرجع ظاهر سوژه است یا مسیر حرکت دوربین؟ «@Video 1» در مستندات این مدل یک برچسب نمونه برای ویدئوی ورودی است، نه واژهای جادویی که بهتنهایی مرجع بسازد. [3]
در H3، قالب پرامپت با نوع ورودی عوض میشود. در حالت پایه، فیلد integrated_multimodal_description مسیر دیداری و کنشها را در طول ویدئو شرح میدهد؛ overall_soundscape صدای محیط و کنش را جمعبندی میکند؛ و non_diegetic_music موسیقیای را مشخص میکند که شخصیتهای صحنه نمیشنوند. راهنمای full-reference شش بخش و برچسبهایی مانند Subject، Picture، Video و Audio دارد و برای همان خروجی ساختاری، انگلیسی را مقرر میکند؛ دیالوگ و نوشتهٔ قابلمشاهده زبان اصلی خود را حفظ میکنند. این دستور به همان حالت تعلق دارد، نه به هر prompt ویدئویی. [4][5]
یک ایده، سه پرامپت متفاوت
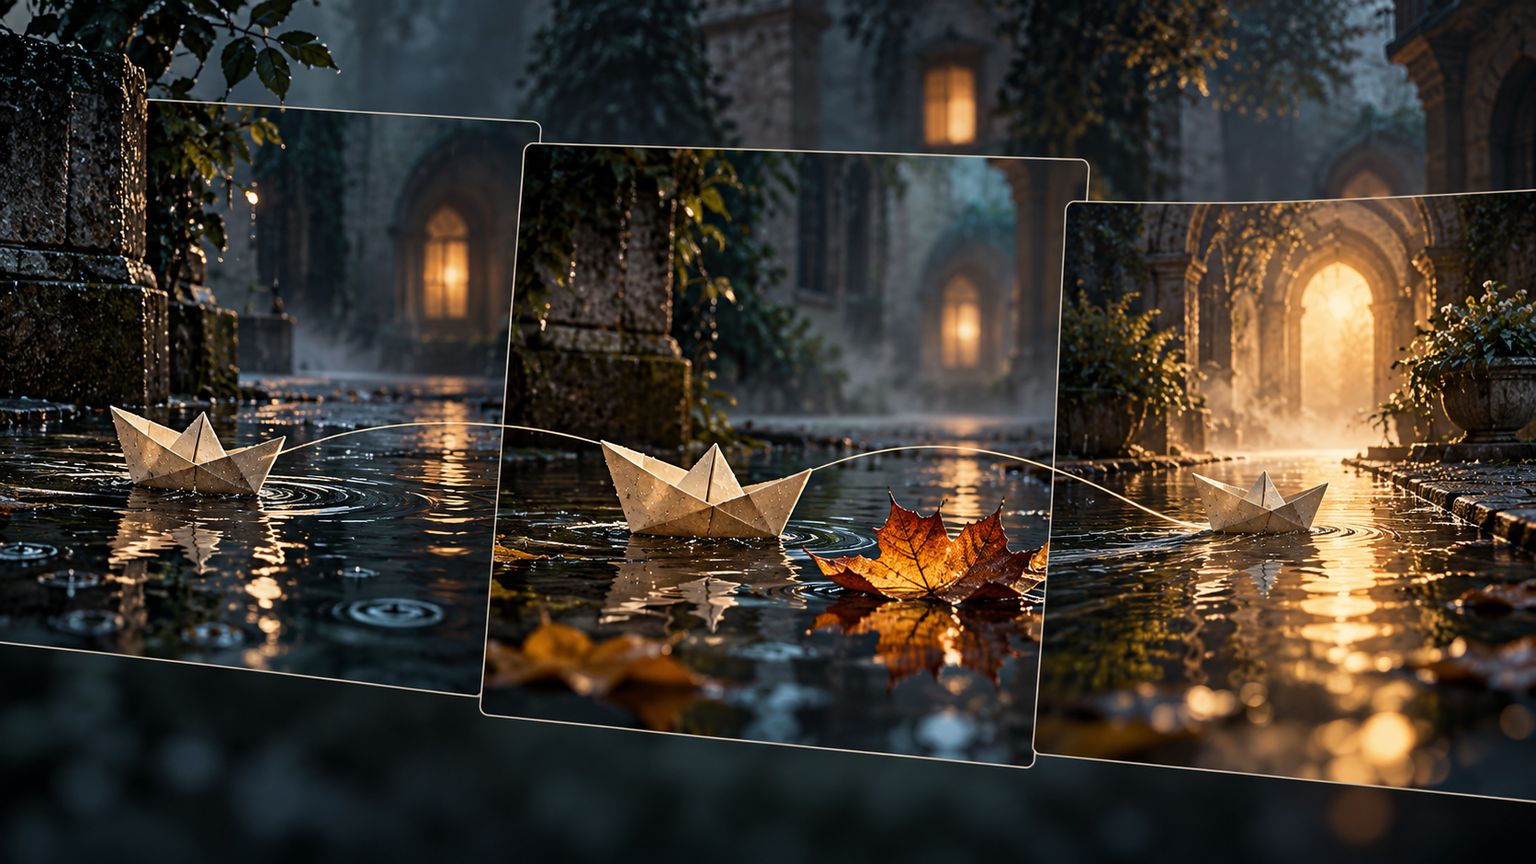
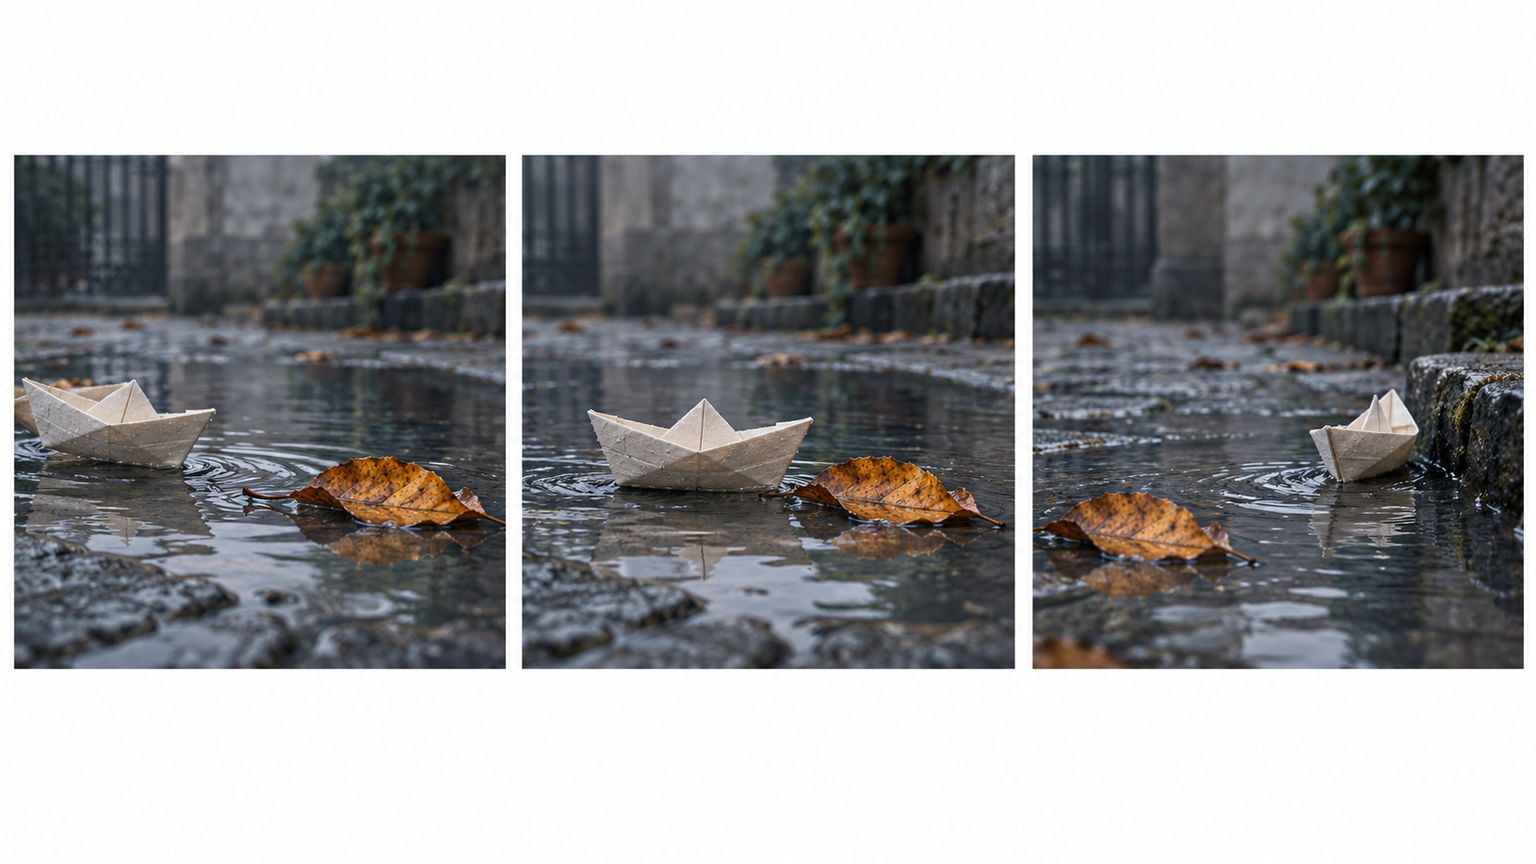
فرض کنید میخواهید قایق کاغذی کوچکی در آب بارانگرفته حرکت کند و از کنار برگ نارنجی بگذرد. اینها نمونههای آموزشیاند؛ رابط هر سرویس ممکن است با API یا محیط دیگری فرق داشته باشد.
برای Gemini Omni Flash، اگر تکبرداشت لازم است، پیوستگی را روشن کنید و دربارهٔ صدا تصمیم بگیرید:
One continuous shot, no cuts. At 0–2 seconds, a small paper boat drifts into a rain-filled courtyard puddle. The camera tracks it at water level. At 2–5 seconds, the boat passes a floating orange leaf and turns gently. Keep the same boat design and lighting throughout. Soft rain and water ripples; no dialogue, no music.
راهنمای Gemini هم زبان طبیعی و هم زمانبندی صریح را میپذیرد؛ برای ویرایش باید فقط چیزی را نام ببرید که قرار است تغییر کند. [2]
برای Seedance 2.5، بازهها و حرکت دوربین را مرحلهبهمرحله بنویسید. اگر تصویر مرجع دارید، شناسهٔ واقعی آن را با نقشش بیاورید:
0–2s: Low water-level tracking shot. A small paper boat enters a rain-filled courtyard puddle.
2–5s: The camera follows as the boat passes an orange leaf, turns gently, and drifts toward the far edge. Maintain the same boat, courtyard, and overcast light. Keep the shot continuous, with no cuts.
این ساختار با نمونههای زمانبندیشدهٔ Seedance همخوان است، اما نقلقول از دستور رسمی نیست. اگر تصویر مرجعی وارد نکردهاید، برچسبی مثل @Image اضافه نکنید. [3]
برای MiniMax H3، در حالت پایه توصیف دیداری و صوتی را در فیلدهای خودش جدا کنید:
integrated_multimodal_description: [Shot 1] A small paper boat drifts into a rain-filled courtyard puddle. At 0–2 seconds, the camera tracks at water level. At 2–5 seconds, the boat passes an orange leaf and turns gently. Maintain the same boat and overcast light.
overall_soundscape: Soft steady rain and small water ripples. No voices.
non_diegetic_music: N/A.
اگر فریم آغاز یا پایان دارید، حالت تولید از متن را انتخاب نکنید: راهنما برای هر نوع ورودی دستور همترازی خودش را دارد. این سه فیلد و دستور همترازی، قالب H3 هستند؛ آنها را عیناً به Gemini یا Seedance منتقل نکنید. [4]
خروجی را چطور اصلاح کنیم؟
اگر ویدئو تقریباً درست است، prompt را از نو ننویسید. یک ایراد را انتخاب کنید: حرکت دوربین بیش از حد تند است؟ قایق از قاب بیرون میرود؟ صدا با تصویر جور نیست؟ همان یک ویژگی را تغییر دهید و صریحاً بگویید چه چیزهایی درستاند و باید بمانند. راهنمای Gemini حفظ بقیهٔ عناصر را در ویرایش پیشنهاد میکند؛ Seedance هم ویرایش زماندار و ادامه از مرجع ویدئویی را در مثالهای رسمی نشان میدهد. [2][3]
با این روش، نتیجهٔ هر دور قابلفهمتر میشود: میدانید کدام تغییر روی خروجی اثر گذاشت. اگر همزمان سبک، حرکت، نور، صدا و داستان را عوض کنید، از نتیجه اطلاعات کمتری دربارهٔ علت بهبود یا افت میگیرید. این یک روش کاری است، نه تضمین اجرای بینقص هر جزئیات.
پیش از تولید اینها را مرور کنید
- نوع کار را مشخص کردهام: ساخت، حرکتدادن تصویر، ادامه یا ویرایش؟
- سوژه در شروع کجاست و چه تغییر قابلدیدنی میکند؟
- حرکت دوربین از حرکت سوژه جدا و روشن است؟
- زمانبندی با تعداد اتفاقهای کلیپ تناسب دارد؟
- نمای پیوسته میخواهم یا برش؟ اگر پیوسته است، صریح نوشتهام؟
- مرجعها را با نقش واقعیشان معرفی کردهام؟
- دیالوگ، صدای محیط و موسیقی را از هم جدا کردهام؟
- در ویرایش هم تغییر موردنظر و هم بخشهای ثابت را گفتهام؟
یک نکته برای مخاطب فارسیزبان: مستندات فعلی Google میگویند انگلیسی کاملاً پشتیبانی شده، اما زبانهای دیگر ارزیابی نشدهاند. بنابراین این راهنما نمیتواند کیفیت prompt فارسی را تضمین کند. یک نمونهٔ کوتاه و نماینده را در محیط خودتان امتحان کنید؛ اگر دقت مهم است، نسخهٔ انگلیسی را هم مقایسه کنید. این محدودیت دربارهٔ مستندات Google است و به دو مدل دیگر تعمیم داده نمیشود. [2]
بهترین prompt لزوماً طولانیترین نیست؛ promptی است که مدل را دربارهٔ حرکت، قاب، نقش مرجع و صدای ناخواسته سرگردان نگذارد. با یک کنش ساده شروع کنید، مسیرش را در زمان بنویسید و syntax مدل انتخابی را از راهنمای خودش بردارید.
منابع و مراجع
- Gemini Omni Flash — Google AI for Developers
- Generate and edit videos with Gemini Omni Flash — Google AI for Developers
- One-take Creation, Flexible Referencing: Introducing Seedance 2.5 — ByteDance Seed Team
- Video Prompt Writing Guide (T2VA / I2VA / FL2VA / L2VA) — MiniMaxAI
- Full-Reference Mode Rewrite Output Format Guide — MiniMaxAI